1 为什么要用 Netty?
- 提供了
JAVA NIO但没有提供针对Protocol Buffer、JSON这些信息格式的封装。 - NIO类库和 API
复杂,网络编程复杂,难度较大。 - 提供上层特有服务,如数据格式封装,客户端权限、简单的数据读取、断连重连、半包读写、心跳等。
JAVA NIO存在epoll bug,selector不能阻塞,CPU 会飚至 100%(只能在 LINUX 内核上重现),Netty 已经解决。原因:
因为
poll和epoll对于突然中断的连接socket会对返回的eventSet事件集合置为POLLHUP或者POLLERR,eventSet事件集合发生了变化,这就导致Selector会被唤醒,进而导致CPU 100%问题。根本原因就是JDK没有处理好这种情况。netty 解决办法:
创建一个新的
Selector。处理机制就是如果发生了这种情况,并且发生次数超过了SELECTOR_AUTO_REBUILD_THRESHOLD(默认512),则调用rebuildSelector()进行Selecttor重建,这样就不用管之前发生了异常情况的那个连接了。因为重建也是根据SelectionKey事件对应的连接来重新注册的。- NIO
epoll bug不是linux epoll的问题,而是JDK自己实现epoll时没有考虑这种情况。
2 为什么Netty 使用NIO而不是AIO?
- Netty 不看重
Windows上的使用,在Linux系统上,AIO 的底层实现仍使用EPOLL,没有很好实现AIO,因此在性能上没有明显的优势,而且被JDK封装了一层不容易深度优化。 - AIO 还有个
缺点是接收数据需要预先分配缓存, 而不是NIO 那种需要接收时才需要分配缓存, 所以对连接数量非常大但流量小的情况, 内存浪费很多。
3 为什么不用Netty5?
Netty5 已经停止开发。
4 Netty 组件
4.1 Channel
代表一个到实体(如一个硬件设备、一个文件、一个网络套接字或者一个能够执行一个或者多个不同的I/O 操作的程序组件)的开放连接,如读操作和写操作。
目前,可以把Channel看作是传入(入站)或者传出(出站)数据的载体。因此,它可以被打开或者被关闭,连接或者断开连接。
生命周期
- ChannelUnregistered:
Channel已经被创建,但还未注册到EventLoop; - ChannelRegistered:
Channel已经被注册到了EventLoop; - ChannelActive:
Channel处于活动状态(已经连接到它的远程节点)。它现在可以接收和发送数据了; - ChannelInactive:
Channel没有连接到远程节点,当这些状态发生改变时,将会生成对应的事件。这些事件将会被转发给ChannelPipeline中的ChannelHandler,其可以随后对它们做出响应。
- ChannelUnregistered:
当这些状态发生改变时,将会生成对应的事件。这些事件将会被转发给ChannelPipeline中的ChannelHandler,其可以随后对它们做出响应。
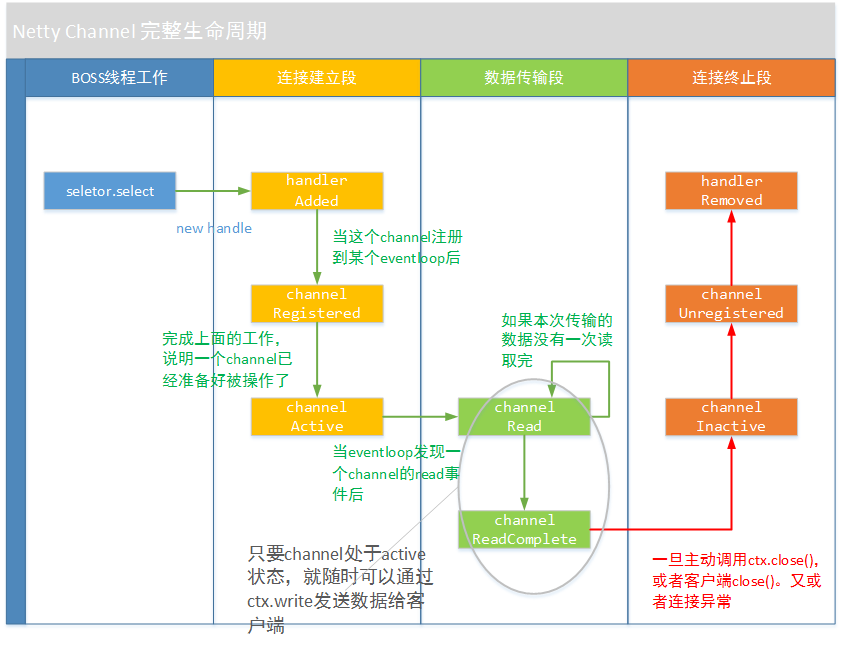
- 接口
基本的 I/O 操作(bind()、connect()、read()和 write())依赖于底层网络传输所提供的原语。在基于 Java 的网络编程中,其基本的构造是类 Socket。Netty 的 Channel 接口所提供的 API,被用于所有的 I/O 操作。大大地降低了直接使用 Socket 类的复杂性。此外,Channel 也是拥有许多预定义的、专门化实现的广泛类层次结构的根。
由于Channel 是独一无二的,所以为了保证顺序将Channel 声明为java.lang.Comparable 的一个子接口。因此,如果两个不同的 Channel 实例都返回了相同的散列码,那么 AbstractChannel 中的 compareTo()方法的实现将会抛出一个 Error。
- 最重要 Channel 的方法
eventLoop: 返回分配给 Channel 的 EventLooppipeline: 返回分配给 Channel 的 ChannelPipelineisActive: 如果 Channel 是活动的,则返回 true。活动的意义可能依赖于底层的传输。 例如,一个 Socket 传输一旦连接到了远程节点便是活动的,而一个 Datagram 传输一旦被 打开便是活动的。localAddress: 返回本地的SokcetAddressremoteAddress: 返回远程的SocketAddresswrite: 将数据写到远程节点。这个数据将被传递给ChannelPipeline,并且排队直到它被冲刷flush: 将之前已写的数据冲刷到底层传输,如一个Socket
+writeAndFlush: 一个简便的方法,等同于调用write()并接着调用flush()
4.2 EventLoop(Group)
回想一下我们在 NIO 中是如何处理我们关心的事件的?
在一个
while循环中select出事件,然后依次处理每种事件。我们可以把它称为事件循环,这就是EventLoop。
interface io.netty.channel.EventLoop 定义了 Netty 的核心抽象,用于处理网络连接的生命周期中所发生的事件。
Netty 的 EventLoop 是协同设计 的一部分,它采用了两个基本的 API:并发和网络编程。
io.netty.util.concurrent包构建在 JDK 的java.util.concurrent包上,用来提供线程执行器。io.netty.channel包中的类,为了与Channel的事件进行交互, 扩展了这些接口/类。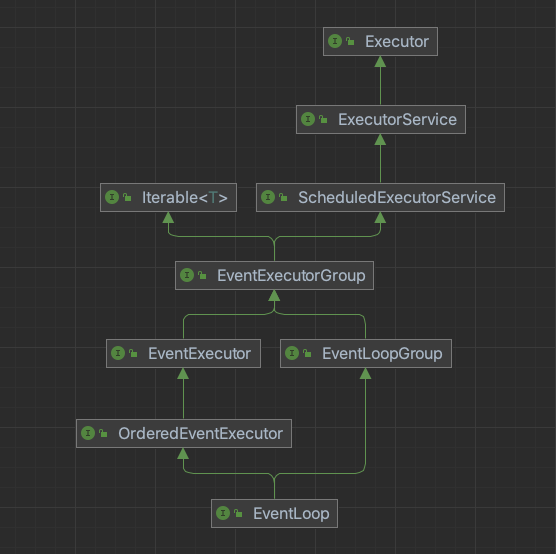 EventLoop类层次结构
- 一个
EventLoop将由一个永远都不会改变的Thread驱动,同时任务(Runnable 或者 Callable)可以直接提交给EventLoop实现,以立即执行或者调度执行。 - Netty 的
EventLoop在继承了ScheduledExecutorService的同时,只定义了一个方法,parent()。在Netty 4中,所有的I/O 操作和事件都由已经被分配给了EventLoop的那个Thread来处理。
EventLoopGroup 是一组 EventLoop,Channel 一般会调用 EventLoopGroup 的 register 方法来绑定其中一个 EventLoop,后续这个 Channel 上的 IO 事件都由此 EventLoop 来处理(保证了 IO 事件处理时的线程安全)。
4.2.1 任务调度
偶尔,你将需要调度一个任务以便稍后(延迟)执行或者周期性地执行。例如,你可能想要注册一个在客户端已经连接了 5 分钟之后触发的任务。一个常见的用例是,发送心跳消息到远程节点,以检查连接是否仍然还活着。如果没有响应,你便知道可以关闭该 Channel 了。
4.2.2 线程管理
在内部,当提交任务到如果(当前)调用线程正是支撑 EventLoop 的线程,那么所提交的代码块将会被(直接)执行。否则,EventLoop 将调度该任务以便稍后执行,并将它放入 到内部队列中。当 EventLoop 下次处理它的事件时,它会执行队列中的那些任务/事件。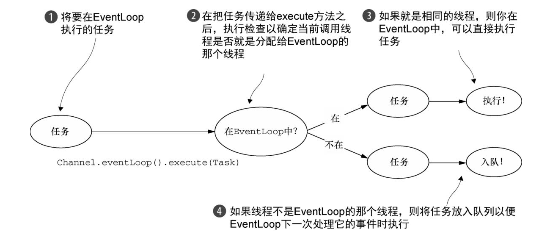
4.2.3 线程分配
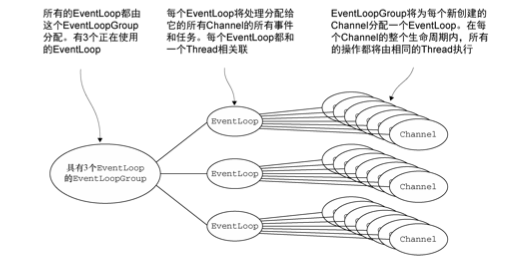
服务于 Channel 的 I/O 和事件的 EventLoop 包含在 EventLoopGroup 中。根据不同的传输实现,EventLoop 的创建和分配方式也不同。
- 异步传输
异步传输实现只使用了少量的 EventLoop(以及和它们相关联的 Thread),而且在当前的线程模型中,它们可能会被多个 Channel 所共享。这使得可以通过尽可能少量的 Thread 来支撑大量的 Channel,而不是每个 Channel 分配一个 Thread。
下图中显示了一个 EventLoopGroup,它具有 3 个固定大小的 EventLoop(每个 EventLoop 都由一个 Thread 支撑)。在创建 EventLoopGroup 时就直接分配了 EventLoop(以及支撑它们的 Thread),以确保在需要时它们是可用的。
- 阻塞传输
用于像 OIO(旧的阻塞 I/O)这样的其他传输的设计略有不同,如下图所示。这里每一个 Channel 都将被分配给一个 EventLoop(以及它的 Thread)。如果你开发的应用程序使用过 java.io 包中的阻塞 I/O 实现,你可能就遇到过这种模型。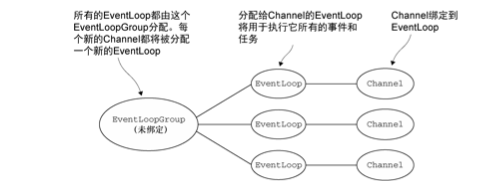
但是,正如同之前一样,得到的保证是每个 Channel 的 I/O 事件都将只会被一个 Thread (用于支撑该 Channel 的 EventLoop 的那个 Thread)处理。这也是另一个 Netty 设计一致性的例子,它(这种设计上的一致性)对 Netty 的可靠性和易用性做出了巨大贡献。
4.3 ChannelFuture
Netty 中所有的 I/O 操作都是
异步的。
JDK 预置了 interface java.util.concurrent.Future,Future 提供了一种在操作完成时通知应用程序的方式。这个对象可以看作是一个异步操作的结果的占位符;
- 它将在未来的某个时刻完成,并提供对其结果的访问。但是其所提供的实现,只允许手动检查对应的操作是否已经完成,或者一直阻塞直到它完成。这是非常繁琐的,所以 Netty 提供了它自己的实现——
ChannelFuture,用于在执行异步操作的时候使用。 - 每个 Netty 的
出站I/O 操作都将返回一个ChannelFuture。也就是说,它们都不会阻塞。 正如我们前面所提到过的一样,Netty 完全是异步和事件驱动的。
4.4 ChannelHandler
从应用程序开发人员的角度来看,Netty 的主要组件是 ChannelHandler,它充当了所有处理入站和出站数据的应用程序逻辑的容器。
ChannelHandler 的方法是由网络事件触发的。 事实上,ChannelHandler 可专门用于几乎任何类型的动作,例如将数据从一种格式转换为另外一种格式,例如各种编解码,或者处理转换过程中所抛出的异常。
- ChannelHandler 的生命周期:在
ChannelHandler被添加到ChannelPipeline中或者被从ChannelPipeline中移除时会调用下面这些方法。这些方法中的每一个都接受一个ChannelHandlerContext参数。handlerAdded:当把ChannelHandler添加到ChannelPipeline中时被调用;handlerRemoved:当从ChannelPipeline中移除ChannelHandler时被调用;exceptionCaught:当处理过程中在ChannelPipeline中有错误产生时被调用。
Netty 定义了下面两个重要的 ChannelHandler 子接口:
ChannelInboundHandler: 处理入站数据以及各种状态变化;ChannelOutboundHandler: 处理出站数据并且允许拦截所有的操作。
另外,3 个 ChannelHandler 的子类型:编码器、解码器和 SimpleChannelInboundHandler<T> —— ChannelInboundHandlerAdapter 的一个子类。
4.4.1 ChannelInboundHandler 接口
下面列出了接口 ChannelInboundHandler 的生命周期方法。这些方法将会在数据被接收时或者与其对应的 Channel 状态发生改变时被调用。正如我们前面所提到的,这些方法和 Channel 的生命周期密切相关。
channelRegistered:当Channel已经注册到它的EventLoop并且能够处理I/O时被调用;channelUnregistered:当Channel从它的EventLoop注销并且无法处理任何I/O时被调用;channelActive:当Channel处于活动状态时被调用;Channel已经连接/绑定并且已经就绪;channelInactive:当Channel离开活动状态并且不再连接它的远程节点时被调用;channelReadComplete:当Channel上的一个读操作``完成时被调用;channelRead:当从Channel读取数据时被调用;ChannelWritabilityChanged:当Channel的可写状态发生改变时被调用。可以通过调用Channel的isWritable()方法来检测Channel的可写性。与可写性相关的阈值可以通过
Channel.config().setWriteHighWaterMark()和Channel.config().setWriteLowWaterMark()方法来设置;userEventTriggered:当ChannelInboundHandler.fireUserEventTriggered()方法被调用时被调用。
4.4.2 ChannelOutboundHandler 接口
出站操作和数据将由 ChannelOutboundHandler 处理。它的方法将被 Channel、ChannelPipeline 以及 ChannelHandlerContext 调用。
所有由 ChannelOutboundHandler 本身所定义的方法:
- bind(ChannelHandlerContext,SocketAddress,ChannelPromise):当请求将
Channel绑定到本地地址时被调用; - connect(ChannelHandlerContext,SocketAddress,SocketAddress,ChannelPromise):当请求将
Channel连接到远程节点时被调用; - disconnect(ChannelHandlerContext,ChannelPromise):当请求将
Channel从远程节点断开时被调用 - close(ChannelHandlerContext,ChannelPromise):当请求
关闭 Channel时被调用; - deregister(ChannelHandlerContext,ChannelPromise):当请求将
Channel从它的EventLoop注销时被调用; - read(ChannelHandlerContext):当请求从
Channel读取更多的数据时被调用; - flush(ChannelHandlerContext):当请求通过
Channel将入队数据``冲刷到远程节点时被调用; - write(ChannelHandlerContext,Object,ChannelPromise):当请求通过
Channel将数据写到远程节点时被调用;
4.4.3 ChannelInboundHandlerAdapter
有一些适配器类可以将编写自定义的 ChannelHandler 所需要的工作降到最低限度,因为它们提供了定义在对应接口中的所有方法的默认实现。因为你有时会忽略那些不感兴趣的事件,所以 Netty 提供了抽象基类 ChannelInboundHandlerAdapter 和 ChannelOutboundHandlerAdapter。
下面这些是编写自定义 ChannelHandler 时经常会用到的适配器类:
- ChannelHandlerAdapter
- ChannelInboundHandlerAdapter
- ChannelOutboundHandlerAdapter
- ChannelDuplexHandler
4.4.4 编码器和解码器
网络数据总是一些字节,需要通过解码解析给系统,让其能够认识;同样从系统写出去的数据,具有普遍认可度的一般是二进制,所以需要进行编码;
对应于特定的需要,Netty 为编码器和解码器提供了不同类型的抽象类。通常来说,这些基类的名称将类似于 ByteToMessageDecoder 或 MessageToByteEncoder。对于特殊的类型,你可能会发现类似于 ProtobufEncoder 和 ProtobufDecoder 这样的名称——预置的用来支持 Google 的 Protocol Buffers。
所有由 Netty 提供的编码器/解码器适配器类都实现 了 ChannelOutboundHandler 或者 ChannelInboundHandler 接口。
4.4.5 抽象类 SimpleChannelInboundHandler
最常见的情况是,你的应用程序会利用一个 ChannelHandler 来接收解码消息,并对该数据应用业务逻辑。要创建一个这样的 ChannelHandler,你只需要扩展基类 SimpleChannelInboundHandler<T>,其中 T 是你要处理的消息的 Java 类型 。在这个 ChannelHandler 中, 你将需要重写基类的一个或者多个方法,并且获取一个到 ChannelHandlerContext 的引用, 这个引用将作为输入参数传递给 ChannelHandler 的所有方法。
在这种类型的 ChannelHandler 中,最重要的方法是 channelRead0(ChannelHandlerContext, T)。除了要求不要阻塞当前的 I/O 线程之外,其具体实现完全取决于你。后续再讲编解码器时,我将对这一主题进行更多的说明。
4.5 ChannelPipeline
当 Channel 被创建时,它将会被自动地分配一个新的 ChannelPipeline。这项关联是永久性的。
Channel 既不能附加另外一个 ChannelPipeline,也不能分离其当前的。在 Netty 组件的生命周期中,这是一项固定的操作,不需要开发人员的任何干预。
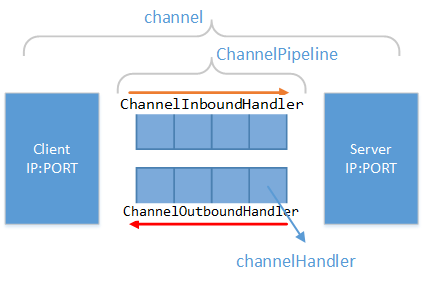
使得事件流经 ChannelPipeline 是 ChannelHandler 的工作,它们是在应用程序的初始化或者引导阶段被安装的。这些对象接收事件、执行它们所实现的处理逻辑,并将数据传递给链中的下一个 ChannelHandler。它们的执行顺序是由它们被添加的顺序所决定的。
4.5.1 ChannelPipeline 中 ChannelHandler
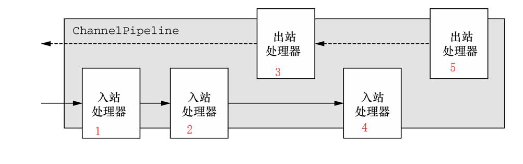
入站和出站 ChannelHandler 可以被安装到同一个 ChannelPipeline 中。如果一个消息或者任何其他的入站事件被读取,那么它会从 ChannelPipeline 的头部开始流动,最终,数据将会到达 ChannelPipeline 的尾端,届时,所有处理就都结束了。
数据的出站运动(即正在被写的数据)在概念上也是一样的。在这种情况下,数据将从 ChannelOutboundHandler 链的尾端开始流动,直到它到达链的头部为止。在这之后,出站数据将会到达网络传输层,这里显示为 Socket。通常情况下,这将触发一个写操作。
如果将两个类别的ChannelHandler都混合添加到同一个ChannelPipeline 中会发生什么。 虽然 ChannelInboundHandle 和 ChannelOutboundHandle 都扩展自 ChannelHandler,但是 Netty 能区分 ChannelInboundHandler 实现和 ChannelOutboundHandler 实现,并确保数据只会在具有相同定向类型的两个 ChannelHandler 之间传递。
4.6 ChannelHandlerContext
通过使用作为参数传递到每个方法的 ChannelHandlerContext,事件可以被传递给当前 ChannelHandler 链中的下一个 ChannelHandler。虽然这个对象可以被用于获取底层的 Channel,但是它主要还是被用于写出站数据。
ChannelHandlerContext 代表了ChannelHandler 和 ChannelPipeline 之间的关联,每当有 ChannelHandler 添加到 ChannelPipeline 中时,都会创建 ChannelHandlerContext。
ChannelHandlerContext 的主要功能是管理它所关联的 ChannelHandler 和在同一个 ChannelPipeline 中的其他 ChannelHandler 之间的交互。
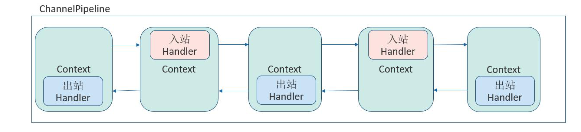
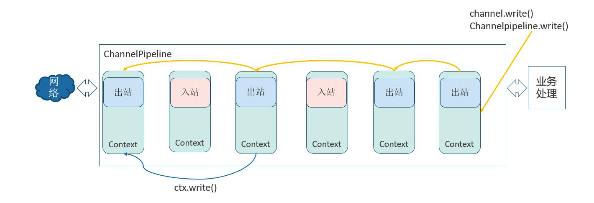
ChannelHandlerContext 有很多的方法,其中一些方法也存在于 Channel 和 ChannelPipeline 本身上,但是有一点重要不同。如果调用Channel 或者ChannelPipeline 上的这些方法,它们将沿着整个 ChannelPipeline进行传播。而调用位于 ChannelHandlerContext上的相同方法,则将从当前所关联的 ChannelHandler 开始,并且只会传播给位于该 ChannelPipeline 中的下一个(入站下一个,出站上一个)能够处理该事件的 ChannelHandler。
4.6.1 ChannelHandlerContext 的 API
alloc返回和这个实例相关联的Channel所配置的ByteBufAllocatorbind绑定到给定的SocketAddress,并返回ChannelFuturechannel返回绑定到这个实例的Channelclose关闭Channel,并返回ChannelFutureconnect连接给定的SocketAddress,并返回ChannelFuturederegister从之前分配的EventExecutor注销,并返回ChannelFuturedisconnect从远程节点断开,并返回ChannelFutureexecutor返回调度事件的EventExecutorfireChannelActive触发对下一个ChannelInboundHandler上的channelActive()方法(已连接)的调用fireChannelInactive触发对下一个ChannelInboundHandler上的channelInactive()方法 (已关闭)的调用fireChannelRead触发对下一个ChannelInboundHandler上的channelRead()方法(已接收的消息)的调用fireChannelReadComplete触发对下一个ChannelInboundHandler上的channelReadComplete()方法的调用fireChannelRegistered触发对下一个ChannelInboundHandler上的fireChannelRegistered()方法的调用fireChannelUnregistered触发对下一个ChannelInboundHandler上的fireChannelUnregistered()方法的调用fireChannelWritabilityChanged触发对下一个ChannelInboundHandler上的fireChannelWritabilityChanged()方法的调用fireExceptionCaught触发对下一个ChannelInboundHandler上的fireExceptionCaught(Throwable)方法的调用fireUserEventTriggered触发对下一个ChannelInboundHandler上的fireUserEventTriggered(Object evt)方法的调用handler返回绑定到这个实例的ChannelHandlerisRemoved如果所关联的ChannelHandler已经被从ChannelPipeline中移除则返回 truename返回这个实例的唯一名称pipeline返回这个实例所关联的ChannelPipelineread将数据从Channel读取到第一个入站缓冲区;如果读取成功则触发一个channelRead事件,并(在最后一个消息被读取完成后)通知ChannelInboundHandler的channelReadComplete(ctx)方法write通过这个实例写入消息并经过ChannelPipelinewriteAndFlush通过这个实例写入并冲刷消息并经过ChannelPipeline
当使用
ChannelHandlerContext的API的时候,有以下两点:
ChannelHandlerContext和ChannelHandler之间的关联(绑定)是永远不会改变的, 所以缓存对它的引用是安全的;- 如同我们在本节开头所解释的一样,相对于其他类的同名方法,
ChannelHandlerContext的方法将产生更短的事件流,应该尽可能地利用这个特性来获得最大的性能。
4.7 内置通讯传输模式
NIO:io.netty.channel.socket.nio使用java.nio.channels包作为基础——基于选择器的方式;Epoll:io.netty.channel.epoll由JNI驱动的epoll()和非阻塞 IO。这个传输支持只有在Linux上可用的多种特性,如SO_REUSEPORT,比NIO传输更快,而且是完全非阻塞的。将NioEventLoopGroup替换为EpollEventLoopGroup, 并且将NioServerSocketChannel.class替换为EpollServerSocketChannel.class即可;OIO:io.netty.channel.socket.oio使用java.net包作为基础——使用阻塞流;Local:io.netty.channel.local可以在VM内部通过管道进行通信的本地传输Embedded:io.netty.channel.embedded,允许使用ChannelHandler而又不需要一个真正的基于网络的传输。在测试ChannelHandler实现时非常有用。
4.8 Bootstrap
网络编程里,服务器和客户端实际上表示了不同的网络行为。换句话说,是监听传入的连接还是建立到一个或者多个进程的连接。
因此,有两种类型的引导:
- 一种用于
客户端(简单地称为Bootstrap); - 另一种用于
服务器(ServerBootstrap)。
无论你的应用程序使用哪种协议或者处理哪种类型的数据, 唯一决定它使用哪种引导类的是:它是作为一个客户端还是作为一个服务器。
比较 Bootstrap 类:
| Differents | Bootstrap | ServerBootstrap |
|---|---|---|
| 网络编程中的作用 | 连接到远程主机和端口 | 绑定到一个本地端口 |
EventLoopGroup 的数目 | 1 | 2 |
为啥
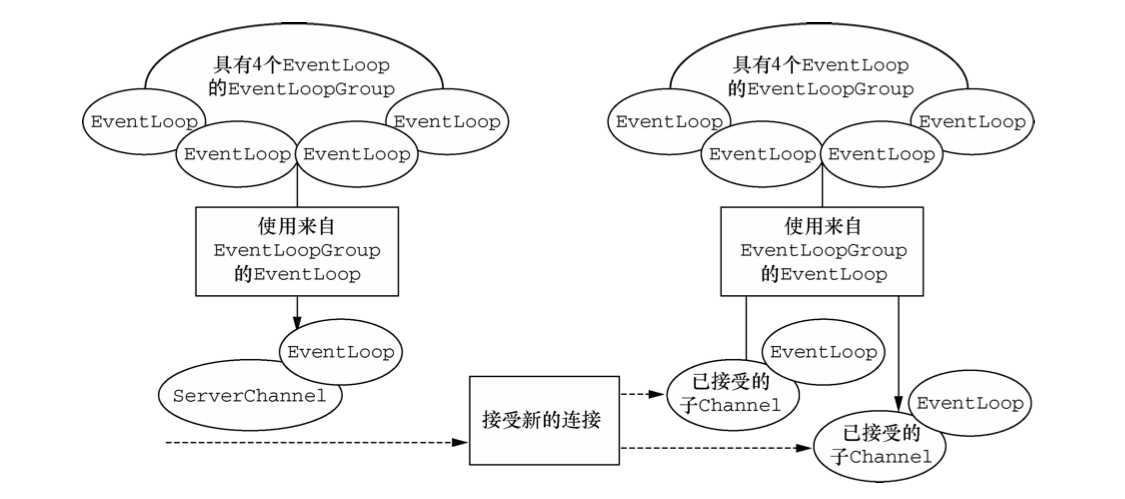
ServerBootstrap需要两个EventLoopGroup?
因为服务器需要两组不同的 Channel:
- 第一组将只包含
一个 ServerChannel,代表服务器自身的已绑定到某个本地端口的正在监听的套接字。- 而第二组将包含所有已创建的用来处理传入
客户端连接(对于每个服务器已经接受的连接都有一个)的Channel。实际上,
ServerBootstrap类也可以只使用一个EventLoopGroup,此时其将在两个场景下共用同一个EventLoopGroup。
4.9 ByteBuf
网络中的数据,其基本单位是字节,在JAVA NIO中,利用ByteBuffer作为字节的数据载体,但是之所以有Netty,不就是因为原生网络编程复杂,且API较晦涩咩?因而Netty提供了另外的载体—-ByteBuf,一个强大的实现,既解决了 JDK API 的局限性, 又为网络应用程序的开发者提供了更好的 API。
4.9.1 工作原理
ByteBuf 维护了两个不同的索引:
- 一个用于
读取 - 一个用于
写入。
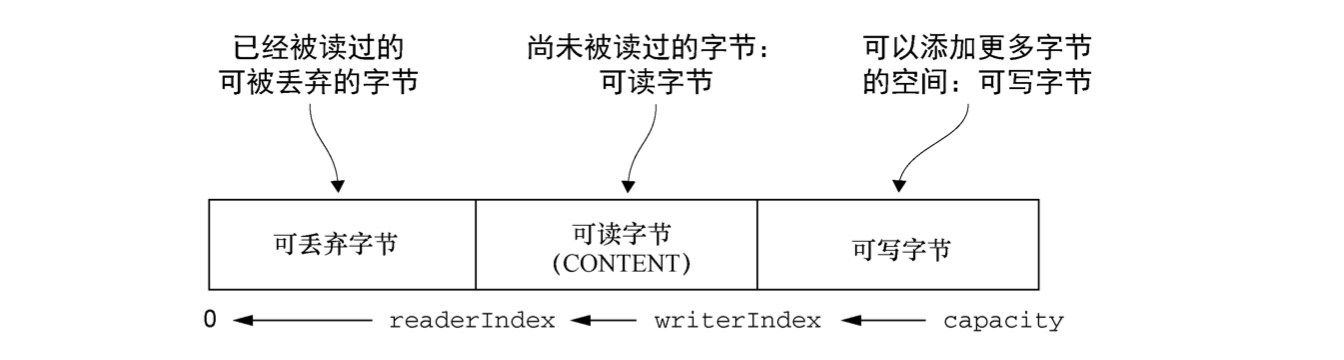
当你从 ByteBuf 读取时, 它的 readerIndex 将会被递增已经被读取的字节数。同样地,当你写入 ByteBuf时,它的 writerIndex 也会被递增。下图展示了一个空 ByteBuf 的布局结构和状态。
要了解这些索引两两之间的关系,请考虑一下,如果打算读取字节直到 readerIndex 达到和 writerIndex 同样的值时会发生什么。在那时,你将会到达可以读取的数据的末尾。就如同试图读取超出数组末尾的数据一样,试图读取超出该点的数据将会触发一个 IndexOutOfBoundsException。
名称以 read 或者 write 开头的 ByteBuf 方法,将会推进其对应的索引,而名称以 set 或 者 get 开头的操作则不会。后面的这些方法将在作为一个参数传入的一个相对索引上执行操作。
可以指定 ByteBuf 的最大容量。试图移动写索引(即 writerIndex)超过这个值将会触发一个异常。(默认的限制是 Integer.MAX_VALUE。)
4.9.1 ByteBuf API 的优点
- 它可以被用户自定义的缓冲区类型
扩展; - 通过内置的
复合缓冲区类型实现了透明的零拷贝; 容量可以按需增长(类似于 JDK 的StringBuilder);- 在
读和写这两种模式之间切换不需要调用ByteBuffer的flip()方法; 读和写使用了不同的索引;- 支持方法的
链式调用; - 支持
引用计数; - 支持
池化.
4.9.2 使用模式
- 堆缓冲区
最常用的 ByteBuf模式是将数据存储在 JVM 的堆空间中。这种模式被称为支撑数组 (backing array),它能在没有使用池化的情况下提供快速的分配和释放。可以由 hasArray() 来判断检查 ByteBuf 是否由数组支撑。如果不是,则这是一个直接缓冲区。
- 直接缓冲区
直接缓冲区是另外一种 ByteBuf 模式。直接缓冲区的主要缺点是,相对于基于堆的缓冲区,它们的分配和释放都较为昂贵。
-复合缓冲区
复合缓冲区CompositeByteBuf,它为多个ByteBuf 提供一个聚合视图。比如HTTP 协议, 分为消息头和消息体,这两部分可能由应用程序的不同模块产生,各有各的 ByteBuf,将会在消息被发送的时候组装为一个 ByteBuf,此时可以将这两个 ByteBuf 聚合为一个 CompositeByteBuf,然后使用统一和通用的 ByteBuf API 来操作。
4.9.3 分配方式
如何在我们的程序中获得 ByteBuf 的实例,并使用它呢?Netty 提供了两种方式。
- 按需分配:ByteBufAllocator 接口
Netty的一种实例分配池化接口。通过 interface ByteBufAllocator 分配我们所描述过的任意类型的 ByteBuf 实例。
下表列出了ByteBufAllocator提供的一些操作。
| 名称 | 描述 |
buffer(); | 返回一个基于堆或者直接内存存储的 ByteBuf |
| buffer(int initialCapacity); | |
| buffer(int initialCapacity, int maxCapacity); | |
heapBuffer(); | 返回一个基于堆内存存储的ByteBuf |
| heapBuffer(int initialCapacity); | |
| heapBuffer(int initialCapacity, int maxCapacity); | |
directBuffer(); | 返回一个基于直接内存存储的ByteBuf |
| directBuffer(int initialCapacity); | |
| directBuffer(int initialCapacity, int maxCapacity); | |
compositeBuffer(); | 返回一个可以通过添加最大到指定数目的基于堆的或者直接内存存储的缓冲区来扩展的 CompositeByteBuf |
| compositeBuffer(int maxNumComponents); | |
| compositeDirectBuffer(); | |
| compositeDirectBuffer(int maxNumComponents); | |
| compositeHeapBuffer(); | |
| compositeHeapBuffer(int maxNumComponents); | |
ioBuffer() | 返回一个用于套接字的 I/O 操作的 ByteBuf |
可以通过 Channel(每个都可以有一个不同的 ByteBufAllocator 实例)或者绑定到 ChannelHandler 的 ChannelHandlerContext 获取一个到 ByteBufAllocator 的引用。
Channel channel = ...;
ByteBufAllocator allocator = channel.alloc(); // 从 Channel 获取一个到 ByteBufAllocator 的引用
 ....
ChannelHandlerContext ctx = ...;
ByteBufAllocator allocator2 = ctx.alloc(); // 从 ChannelHandlerContext 获取一个到 ByteBufAllocator 的引用
 ...
两种ByteBufAllocator的实现
- PooledByteBufAllocator(默认):
池化了ByteBuf的实例以提高性能并最大限度地减少内存碎片。- UnpooledByteBufAllocator:实现
不池化ByteBuf实例,并且在每次它被调用时都会返回一个新的实例。
- Unpooled 缓冲区
Netty 提供了一个简单的称为 Unpooled 的工具类ByteBufUtil,它提供了静态的辅助方法来创建未池化的 ByteBuf 实例。
Unpooled 类还使得 ByteBuf 同样可用于那些并不需要 Netty 的其他组件的非网络项目, 使得其能得益于高性能的可扩展的缓冲区 API。
4.9.4 字节级操作
4.9.4.1 随机访问索引
类似java的字节数组遍历。
ByteBuf buffer = ...;
for (int i = 0; i < buffer.capacity(); i++) {
  byte b = buffer.getByte(i);
  System.out.println((char)b);
}
需要注意的是,使用那些需要
一个索引值参数的方法(的其中)之一来访问数据既不会改变 readerIndex也不会改变 writerIndex。如果有需要,也可以通过调用readerIndex(index)或者writerIndex(index)来手动移动这两者。
4.9.4.2 顺序访问索引
虽然 ByteBuf 同时具有读索引和写索引,但是 JDK 的 ByteBuffer 却只有一个索引,这 也就是为什么必须调用 flip()方法来在读模式和写模式之间进行切换的原因。
4.9.4.3 可丢弃字节
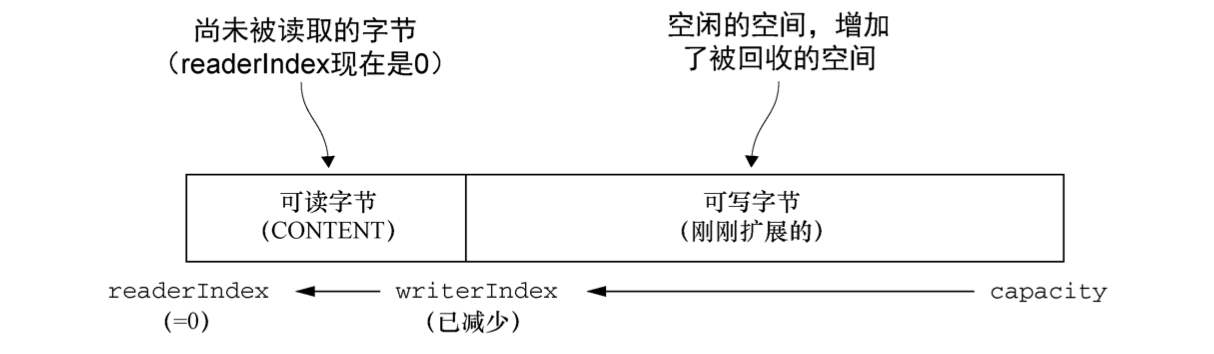
可丢弃字节的分段包含了已经被读过的字节。通过调用 discardReadBytes()方法,可以丢弃它们并回收空间。这个分段的初始大小为 0,存储在 readerIndex 中,会随着 read 操作的执行而增加(get*操作不会移动 readerIndex)。
缓冲区上调用 discardReadBytes()方法后,可丢弃字节分段中的空间已经变为可写的了。 频繁地调用 discardReadBytes()方法以确保可写分段的最大化,但是请注意,这将极有可能会导致内存复制,因为可读字节必须被移动到缓冲区的开始位置。建议只在有真正需要的时候才这样做,例如,当内存非常宝贵的时候。
4.9.4.4 可读字节
ByteBuf 的可读字节分段存储了实际数据。新分配的、包装的或者复制的缓冲区的默认的 readerIndex 值为 0。
4.9.4.5 可写字节
可写字节分段是指一个拥有未定义内容的、写入就绪的内存区域。新分配的缓冲区的 writerIndex 的默认值为 0。任何名称以 write 开头的操作都将从当前的 writerIndex 处开始 写数据,并将它增加已经写入的字节数。
4.9.4.6 索引管理
调用 markReaderIndex()、markWriterIndex()、resetWriterIndex()和 resetReaderIndex()来标记和重置 ByteBuf 的 readerIndex 和 writerIndex。
也可以通过调用 readerIndex(int)或者 writerIndex(int)来将索引移动到指定位置。试图将任何一个索引设置到一个无效的位置都将导致一个 IndexOutOfBoundsException。
可以通过调用 clear()方法来将 readerIndex 和 writerIndex 都设置为 0。注意,这并不会清除内存中的内容。
4.9.4.7 查找操作
在 ByteBuf 中有多种可以用来确定指定值的索引的方法。最简单的是使用 indexOf()方法。较复杂的查找可以通过调用 forEachByte()。
代码展示了一个查找回车符(\r)的例子。
ByteBuf buffer = ...;
int index = buffer.forEachByte(ByteBufProcessor.FIND_CR);
4.9.4.8 派生缓冲区
派生缓冲区为 ByteBuf 提供了以专门的方式来呈现其内容的视图。这类视图是通过以下方法被创建的:
- duplicate();
- slice();
- slice(int, int);
- Unpooled.unmodifiableBuffer(…);
- order(ByteOrder);
- readSlice(int)。
每个这些方法都将返回一个新的 ByteBuf 实例,它具有自己的读索引、写索引和标记索引。其内部存储和 JDK 的 ByteBuffer 一样也是共享的。
ByteBuf 复制如果需要一个现有缓冲区的真实副本,请使用copy()或者copy(int, int)方法。不同于派生缓冲区,由这个调用所返回的ByteBuf拥有独立的数据副本。
4.9.4.9 引用计数
引用计数是一种通过在某个对象所持有的资源不再被其他对象引用时释放该对象所持有的资源来优化内存使用和性能的技术。Netty 在第4 版中为ByteBuf引入了引用计数技术, interface ReferenceCounted。
4.9.4.10 资源释放
当某个 ChannelInboundHandler 的实现重写 channelRead()方法时,它要负责显式地释放与池化的 ByteBuf 实例相关的内存。
Netty 为此提供了一个实用方法 ReferenceCountUtil.release()。
Netty 将使用 WARN 级别的日志消息记录未释放的资源,使得可以非常简单地在代码中发现违规的实例。但是以这种方式管理资源可能很繁琐。一个更加简单的方式是使用 SimpleChannelInboundHandler,它会自动释放资源。
对于
入站请求,Netty 的EventLoop在处理 Channel 的读操作时进行分配 ByteBuf,对于这类 ByteBuf,需要我们自行进行释放,有三种方式:- 使用
SimpleChannelInboundHandler - 在
重写 channelRead()方法使用ReferenceCountUtil.release() - 使用
ctx.fireChannelRead继续向后传递;
- 使用
- 对于
出站请求,不管 ByteBuf 是否由我们的业务创建的,当调用了write或者writeAndFlush方法后,Netty 会自动替我们释放,不需要我们业务代码自行释放。
下一个章节将举个栗子,初识下Netty的应用基础用法。
参考资料:
- 《Netty in Action》